
29篇脑电脑机接口论文盘点:六成说明数据可用,仅两成公开代码" />
/ EN
2026-09-15 00:00 论文发表 基础与方法 译自 EN

129篇脑电脑机接口论文盘点:六成说明数据可用,仅两成公开代码

内容概述 公开的脑电脑机接口数据集越来越多,但电极怎么摆、任务怎么定义、数据怎么预处理、受试者情况怎么记录,各家都不一样,结果就是数据很难跨数据集复用,别人也很难复现。这篇综述从16920条记录里筛出129篇文献,按结构、语义、流程、受试者背景和计算五个层面梳理了这种碎片化,并用10项标准评估报告透明度,中位数为9分。数据可用性在61.2%的文献中有说明,代码或流程可用性只有20.9%。作者认为,现有标准、本体、软件平台和迁移学习方法各自解决了部分问题,但还做不到完整的语义互操作。
推荐理由 这篇综述把脑机接口领域一个不太上新闻但很实际的问题摆了出来:数据集不是不够多,而是对不上。129篇文献里只有两成公开了代码或处理流程,意味着大部分结果别人没法原样跑一遍。对做算法的人来说,这解释了为什么跨数据集训练常常掉点;对准备建库的团队来说,它列出了需要提前统一的字段。

129篇脑电脑机接口论文盘点:六成说明数据可用,仅两成公开代码
图片来源:Sensors (Basel, Switzerland),CC BY 4.0

脑机百科消息(bciwiki.com),公开的脑电脑机接口数据集正在快速增加,但传感器、实验方案、任务与事件语义、预处理方式、受试者背景和评估设计上的差异,限制了结果的可重复性和跨数据集学习。拉脱维亚图里巴大学信息技术学院与里加技术大学信息技术研究所的研究者对此做了一项系统性映射综述,2026年9月15日发表于《Sensors》。综述检索了Scopus、Web of Science核心合集、IEEE Xplore、PubMed和ACM数字图书馆中2014年至2026年6月发表的文献,共得到16920条记录,经筛选和以证据为中心的整理后保留129篇出版物,并经全文复核确认。

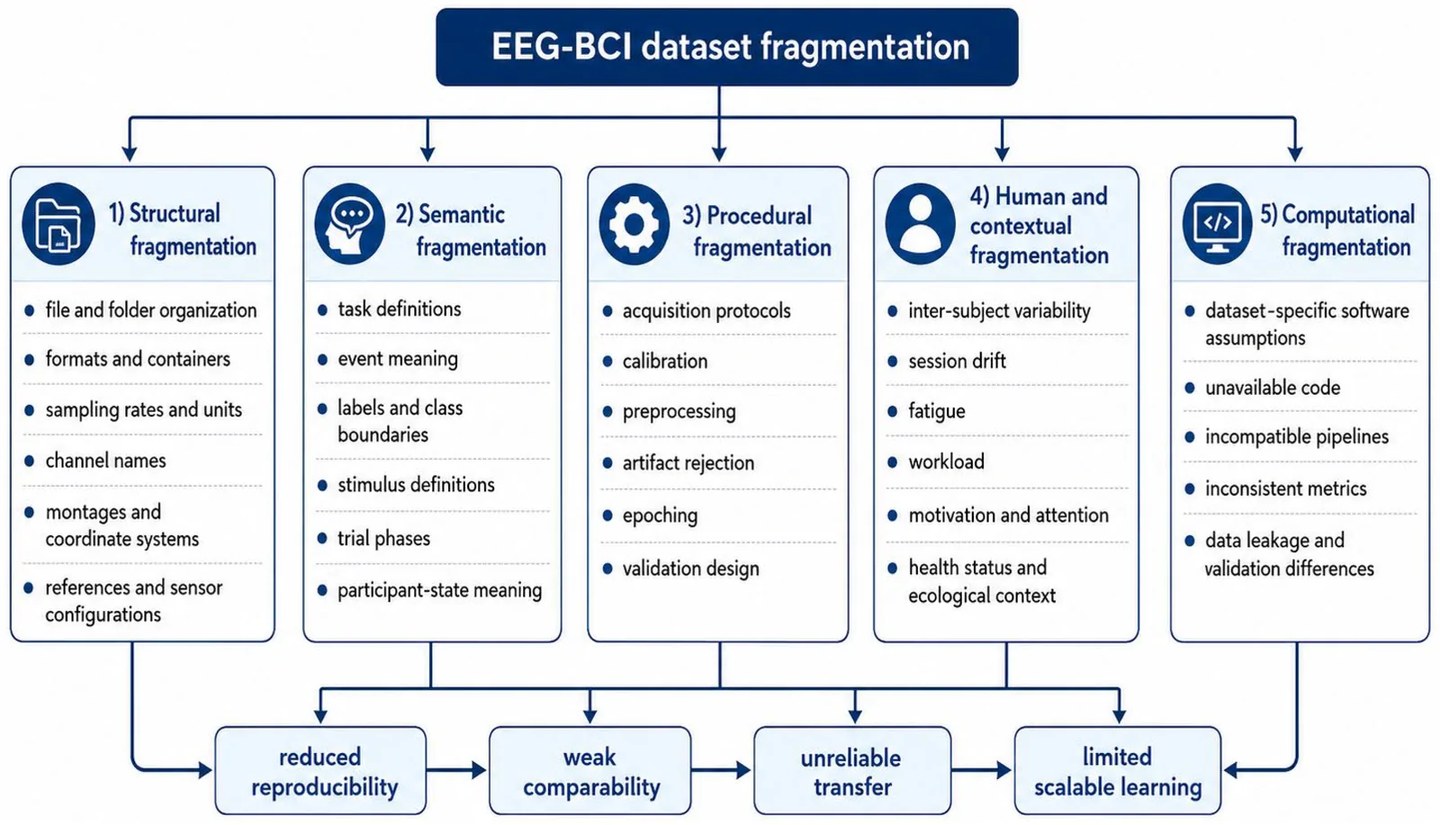
综述把碎片化归纳为结构、语义、流程、受试者与背景、计算五个层面,覆盖采集方式、通道布局、任务与事件定义、预处理、受试者与场次背景以及评估设计上的差异。报告透明度用10项标准评估,保留语料库的中位得分为9分;数据可用性在61.2%的文献中有说明,代码或流程可用性在20.9%中有说明。作者强调,这些比例描述的是这份经过整理的语料库,而不是整个领域。

综述指出,现有标准、本体、软件平台、基准框架和迁移学习方法各自覆盖了互补的层面,但尚未提供完整的语义互操作。作者认为,可扩展的跨数据集分析需要依赖分析目标的兼容性规则、明确的来源信息、上下文元数据,以及可审计的转换过程,从而保留数据集身份、不确定性和信息损失。

本文由 BCIwiki 根据公开信息撰写

关联信源 · 1
阅读原文 ↗
指正 修订记录 · 无 / EN
© 2026 BCIwiki.com 产业简报 主题索引 提交线索 订阅本站 修订记录 关于我们