11-02 论文发表 基础与方法 丹麦技术大学等研究通过脑电和上下文检索已阅读句子 一项研究提出层级对齐框架,探索结合脑电信号与上下文,检索被阅读的句子。研究聚焦句子级脑电到文本分类,而不是直接生成句子,也不是仅凭脑电识别任意思想。作者指出,以往不少解码研究围绕音素、字母和单词展开,而句子能够承载更完整的语义;在句子级任务中,分类受到的研究关注又少于生成。该框架旨在研究脑电与文本的对应关系,为如何选择句子检索或生成路径提供研究方向。非侵入式辅助交流是其应用背景,不代表已验证沟通障碍人群的使用效果。 查看详情 →
10-23 · Synchron 等 2 家 澳大利亚美国 论文发表 沟通与语言 墨尔本大学用血管内脑机接口识别尝试手写字符,完成单人在线测试 墨尔本大学研究人员让一名植入Stentrode血管内脑机接口的参与者尝试手写英文字符,利用脑信号随时间变化的轨迹进行离线和在线分类。在4次在线测试中,每次包含每个字符20-30次试次及80-180次休息试次,表现最佳的3分类模型平均休息召回率为87%,字符召回率和精确率分别为65%和59%。研究还发现,将各试次调整为相同时长后,分类表现显著优于直接使用原始试次。结果支持进一步研究时间信息在运动解码中的作用,但目前仅来自一名参与者和少量类别。 查看详情 →
10-23 论文发表 康复与辅助 哥伦比亚大学医学中心合作研究发现,41名临床无反应患者中13人能控制脑机接口 哥伦比亚大学医学中心参与的一项前瞻性单中心研究发现,41名临床无反应的急性脑损伤重症患者中,13人(32%)能够控制脑机接口。系统实时分析脑电,将患者尝试运动时的信号转为声音变化。实现控制者中,4/13在出院时恢复临床意识,未实现控制者为1/28;12个月时,达到研究所定义功能独立标准的比例分别为6/13和2/28。结果显示,脑机接口控制能力与后续恢复相关,但不能证明使用设备促进了恢复。此次测试的是单向控制,双向交流仍属未来应用方向。 查看详情 →
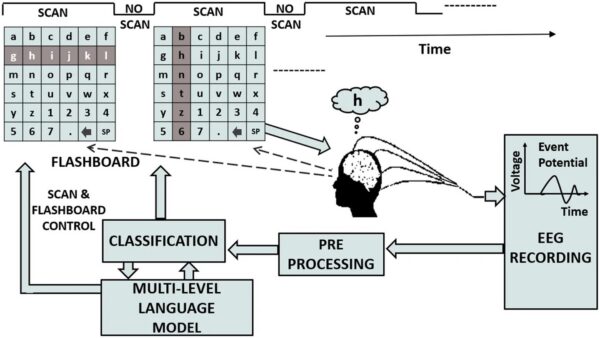
10-22 · University at Buffalo, State University of New York 美国 论文发表 康复与辅助 布法罗大学结合脑机接口与眼动,加快符号选择并减少误选 布法罗大学作者评估脑机接口与眼动追踪结合的辅助沟通系统。眼动先缩小目标范围,再由脑信号确认选择;实验报告其选择速度快于单独脑机接口,控制表现优于单独眼动,并减少误选和纠错负担。 查看详情 →
10-21 · University of Essex 英国 论文发表 基础与方法 埃塞克斯大学用脑电区分语义类别,两两分类准确率最高73.4% 埃塞克斯大学团队记录14名参与者根据语言线索检索概念时的脑电,比较食物、乐器和身体部位三类概念。三个两两分类任务的平均准确率分别为73.4%、70.7%和68.2%。模型先用其他人的数据学习,再用待测参与者自己的带标签数据校准。 查看详情 →
10-20 论文发表 基础与方法 Araya Inc.参与研究:脑电语音解码贡献不能仅用肌电关联解释 Araya Inc.与Sincxpress Education SRL研究人员分析了利用超高密度脑电预测口语单词的模型,考察解码依据是否来自神经活动,而非说话时的肌肉电活动。结果显示,各电极对解码的贡献无法用其与肌电的互信息解释;脑电解码依赖的时段也不同于仅使用肌电的解码。有声言语与极轻微外显言语的脑电解码贡献时段存在部分重叠。在所有言语条件下,去噪均增强了言语相关脑区电极对解码的贡献。作者据此认为,适当预处理有助于利用脑电中的神经活动解码口语单词。 查看详情 →
10-19 论文发表 沟通与语言 内布拉斯加大学林肯分校等测试24名儿童,场景界面更受青睐 内布拉斯加大学林肯分校与奥马哈分校研究人员在24名8至13岁神经典型儿童中比较三种沟通界面。场景界面与标准网格的脑机接口离线预测表现相近,儿童认为场景更具视觉吸引力;布局和背景也对应不同的脑电反应。 查看详情 →
10-19 论文发表 基础与方法 牛津大学合并脑磁信号,复测音素分类比冠军模型高17.4个百分点 牛津大学团队比较6种重复信号聚合方法,在7个场景中有6个由训练时分类分数平均领先。主要音素比较合并100次同类试验,公开测试集上复测的平衡准确率为64.1%,比冠军模型高17.4个百分点。实验使用脑磁图记录,研究为预印本。 查看详情 →
10-16 论文发表 基础与方法 脑信号转文字新方法用更少参数完成两项基准测试 研究团队提出名为BEST的两阶段方法,将神经活动转换为文字,探索语音脑机接口是否必须依赖大模型。在Brain-to-Text '24和'25两项基准测试中,该方法的词错误率分别为6.19%和1.62%,参数量仅为可比方法的3.85%。词错误率衡量输出文字相对参考文本的错误程度,数值越低表示错误越少。作者的分析认为,扩大解码器并不总能带来更好的表现,神经信号、语音与文字之间的对应关系比模型大小更关键。这些结果属于基准测试表现,不能直接等同于日常交流效果。 查看详情 →
10-14 论文发表 基础与方法 脑电语音解码审查发现:出声说话的对照表现主要由肌源信号主导 研究人员审查三个公开语料库,发现出声说话时的解码表现可能不足以证明流程能识别脑源语音信号。在ds003626中,两个唇部电极的解码准确率为0.7430,高于128通道头皮电极阵列的0.4231;限制在8-30Hz后,未保留可解码信号。研究还向真实记录注入已知幅度的效应,测量不同方法能检测到多小的变化,发现方法之间存在差异。作者认为,这些语料库的外显言语阳性对照主要由肌源性信号主导,并建议同时报告频段、伪迹通道表现及实测检测下限,以帮助解释解码成功或未检出的结果。 查看详情 →
10-14 论文发表 基础与方法 想象语音解码跨人测试接近随机水平,研究复核三个脑电语料库 研究人员分析三个公开语料库,检验用一人的头皮脑电训练的想象语音解码器能否用于另一人。在482个受试者有序对中,没有任何一对在多重比较校正后保持显著;各语料库的平均迁移准确率与随机水平相差均不超过0.006。研究还发现,区分想象任务与刺激前静息的信号,更符合刺激后状态,而非想象活动本身。单人内部解码中,只有竞赛语料库的所有受试者均超过阈值,但其频率特征未通过伪迹审查。结果限定于这些语料库和所检验的表示方式,不能推广为所有想象语音解码均不可行。 查看详情 →
10-14 论文发表 基础与方法 研究将脑电与文本对齐,探索想象语音的语义解码 研究人员将想象说话时的脑电信号与文本的语言表示对齐,希望在识别固定意图之外,利用不同表达之间的语义关系。研究在Chisco想象语音数据集的5名受试者、39个意图类别上评估了这一框架,解码表现与针对该任务优化的闭集分类器相当。脑电与文本的最大相似度还能筛选出Top-1和Top-5准确率更高的留出试验子集。五个语义维度的平均一致率均高于50%的机会水平参照;对未见候选句子的比较则属于定性展示,不能据此认定系统已能自由读取任意想象语句。 查看详情 →
10-09 论文发表 康复与辅助 成人探索研究发现脑机接口学习表现与阅读进步相关 研究开发了一种结合听觉输入和视觉反馈的非侵入式脑电脑机接口,目标是支持发展性阅读障碍相关的语音加工,并先在有、无阅读障碍的成人中测试。参与者完成16次训练,接受训练前后的语音意识及单词、非词阅读测评。在学会使用该系统的参与者中,无论是否有阅读障碍,离线脑机接口学习分数均与非词阅读进步显著相关。研究还发现,系统学习表现与真实单词阅读及声音振幅上升时间辨别能力的改善显著相关。这些关联不能证明训练导致阅读改善,也不是婴幼儿或儿童疗效证据。 查看详情 →
10-09 论文发表 基础与方法 语言描述辅助脑信号解码,语音任务准确率最多提高17.15个百分点 研究者用自然语言描述待识别的类别,帮助模型学习脑信号与类别之间的对应关系,并在视觉、运动和语音解码任务中评估这一方法。研究覆盖七种编码器架构,使用头皮和颅内记录,各任务模型独立训练。与匹配的类别标签监督基线相比,语音解码准确率最多提高17.15个百分点。研究还报告,所学表征支持候选类别集合复用,以及有标签监督的受试者和会话适配;在稳态视觉诱发电位任务中,可在特定条件下解码训练中未见过的频率。这些结果并不代表一个统一模型已能直接完成全部任务,或无需标签即可适配新受试者。本研究为预印本,尚未经同行评审。 查看详情 →
10-06 论文发表 基础与方法 上下文先验让脑磁图解码更准,也让部分错误更自信 给脑磁图语音解码加上下文先验,能提高整体准确率,但一项新研究提示,这也会让一部分本可纠正的错误变得更“自信”。研究团队在两个脑磁图数据集上追踪候选词得分变化,发现一种反转:正确候选原本排在局部前列时,融合后前两名的分差越大越可能被纠正;起始排名靠后时,分差越大反而更可能维持错误。在MEG-MASC上,整体判断正误的AUROC为0.87,而区分“纠正”与“残留错误”的AUROC从0.70跌到0.39;起始排名第20位之后的错误占融合后错误的46.6%。作者建议,置信度不应只读融合后的分数,还要保留局部与上下文证据;拆分后解码器可在74.5%的时间窗内作答,高于原来的56.7%。该研究为预印本,尚未经同行评审。 查看详情 →
10-05 论文发表 基础与方法 想象发声时的面部肌肉活动影响脑电情绪解码 研究人员记录出声和想象发声时的脑电,尝试区分愤怒、快乐、中性、悲伤和愉悦五类情绪。出声实验纳入14名参与者,想象发声实验纳入21名参与者,单试次解码准确率分别为78.1%和36.4%,随机水平为20%。研究还在5名参与者想象发声时记录面部表面肌电,发现非自主肌肉活动参与形成了有助于分类的脑电频谱与空间模式,其中一种侧部通道模式在想象快乐发声时更强。这意味着,分类准确率不能全部归于脑源情绪信息,也不能把肌肉活动影响忽略为普通背景噪声。 查看详情 →
10-05 论文发表 基础与方法 ISAE-SUPAERO半干式脑机接口在30人屏幕打字测试中实现99.8%准确率 ISAE-SUPAERO的一项研究测试了结合半干式脑电采集与视觉刺激的脑机接口。30名参与者完成标准屏幕上的11类键盘打字任务,系统使用33秒校准数据,准确率为99.8%,平均解码时间为4.3秒。在两次在线打字测试之间的2分钟观看视频空闲条件下,未出现误指令。研究还开展了虚拟现实概念验证,在线准确率为100%,平均解码时间为5.6秒。参与者主观报告两种条件下视觉舒适度较高、周边干扰较少,但虚拟现实中的疲劳更高;短时空闲测试不能代表长期使用表现。 查看详情 →
10-01 · University of Washington 美国 论文发表 沟通与语言 大语言模型助力P300拼写器打字提速最高75%,性能已逼近理论上限 P300拼写器是一种让渐冻症等重度瘫痪患者靠脑电“打字”的脑机接口:屏幕上的字符轮流闪烁,用户盯住想要的那个字,脑电里会出现一个叫P300的特征波,系统据此判断要输入哪个字。它的短板是慢,而且每个人都要单独校准。研究团队用78名受试者的脑电数据做模拟,比较了多种语言模型帮助预测词语的效果:打字速度比传统方法最高提升约45%(按个人数据训练)和约75%(跨受试者训练)。几个表现最好的模型结构各不相同,却都已落在理论上限5%以内,说明继续把语言模型做大收益有限,下一步的瓶颈在于脑信号解码本身。该结论来自离线模拟,并非患者实际使用测试。 查看详情 →
09-30 论文发表 基础与方法 脑电听觉注意力解码新方法:嘈杂环境中识别聆听对象,准确率提升9%至16% 在嘈杂的房间里,大脑会专注听其中一个人说话,这被称为“鸡尾酒会问题”。助听器和脑机接口如果能从脑电信号中读出用户在听谁,就知道该放大哪个声音。研究人员提出名为NEUROTOKEN的单一网络,用条件流匹配方法给候选声源打分。在KU Leuven、DTU和NJU三个公开数据集上,以5秒时间窗计算,识别聆听对象的分段准确率比最强的非生成式基线高出9%至16%,受试者间差异缩小约3倍。研究还发现,以往报告的95%至97%方向判别准确率,在训练与测试严格分开试次后会下降17%至45%。该研究为预印本,尚未经同行评审。 查看详情 →
09-29 论文发表 沟通与语言 语音脑机接口综述:评价标准不应只看离线准确率 语音脑机接口想做的,是把与说话、语言或交流意图相关的神经活动转成文字、合成语音或虚拟形象的动作,帮失去说话能力的人重新交流。这篇综述认为,它并不只是一台把脑信号翻译成文字的解码器,而是一个会随时间变化的临床系统:神经表征、记录硬件、解码算法、语言模型、反馈和使用者自身的学习相互影响。作者提出,下一代语音脑机接口不能只比离线准确率,还要看跨天使用是否稳定、校准负担多重、延迟多长、能否表达不确定性、好不好用,以及能否防止把不想说的话解码出来。该研究为预印本,尚未经同行评审。 查看详情 →
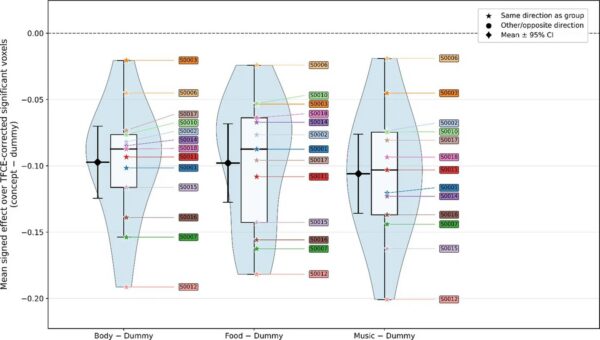
09-29 · University of Essex 英国 论文发表 基础与方法 埃塞克斯大学:人听懂词义时,脑电低贝塔节律会一致减弱 人在听懂一段描述并想出对应概念时,大脑的脑电节律会不会出现稳定可辨的变化?英国埃塞克斯大学团队设计了一个听觉猜词游戏。受试者先听一句口语定义,再说出它指的是哪个具体概念,例如身体部位、食物或乐器。对照条件是发音相近、但几乎不含词义的伪词句子。研究共分析13名健康受试者的64通道头皮脑电。结果显示,在作答前的提取阶段,3个类别都出现了低贝塔频段功率下降,峰值约在15赫兹附近,而且13人的方向全部一致。研究者认为,相比分辨具体是哪个概念,区分“有意义”和“无意义”的状态可能是更适合跨人使用的信号目标,可供未来直接解码语义的脑机接口参考。 查看详情 →
09-27 论文发表 沟通与语言 语音脑机接口不配GPU也行:云端小模型挑句子,错词率不输70亿参数大模型 语音神经假体从大脑活动中解码患者尝试说出的话,最后一步通常要用一个数十亿参数的语言模型给候选句子重新打分,这是整套系统里唯一需要GPU的环节。Gabriele Cinà于2026年9月27日在arXiv发布的研究改用托管模型Jev,一次调用给每个候选句子输出一个概率,再与解码器自身的评分结合。在一名渐冻症(ALS)参与者的978个保留句子上,已发表解码器单独使用时词错误率为8.1%,Jev为7.5%,OPT-6.7b与Qwen2.5-7B均为7.8%;重新调整解码器权重后,三者分别为6.9%、7.2%和7.4%。Jev不需要GPU,每千句成本0.07美元,经互联网的端到端延迟为262毫秒,慢于本地GPU上7B模型的27毫秒。该研究为预印本,尚未经同行评审。 查看详情 →
09-25 论文发表 沟通与语言 融合功能磁共振与脑磁图的新方法提升跨被试语音解码准确率 研究人员提出名为SICMD的方法,把功能磁共振成像(fMRI)和脑磁图(MEG)两种非侵入式脑信号结合起来,从大脑活动中识别一个人正在听的语音,并且让同一个模型适用于不同的人。fMRI擅长定位活动发生在哪里,MEG擅长捕捉活动发生的时间,两者结合可以得到更完整的时空信息。在跨被试的感知语音解码任务中,该方法的Top-1、Top-10和Rankacc三项指标比基线方法分别提高10.6%、10.1%和1.7%以上。与多被试解码和被试内解码相比,训练成本分别降低88.8%和60.5%。该研究为预印本,尚未经同行评审。 查看详情 →
09-25 论文发表 基础与方法 从脑信号读“心里默念的话”:信号越弱,语言模型帮的忙越大 想象中说的话,比耳朵听到的话更难从脑信号里读出来:大脑反应弱、噪声大,可用的数据也少。研究团队用一套同一批内容既“听”又“想”的脑磁图(MEG,一种在头皮外记录大脑磁场的无创技术)数据集,在训练和解码两个环节接入语言模型。结果显示,想象语音从语言模型中获益比听到的语音更多,而且最佳效果需要更多依赖语言模型。作者据此认为,脑信号证据越弱,语言模型提供的上下文先验越有用。该研究为预印本,尚未经同行评审。 查看详情 →
09-24 论文发表 基础与方法 想象语音脑电解码接受跨被试检验,频谱特征准确率达49.03% 只在心里默念、不发出声音的“想象语音”,能否从头皮脑电中读出来,并且换一个没参与训练的人也同样有效?研究人员用严格的被试无关方案重新检验了一个多类想象语音脑电数据集:模型从不在测试对象本人的数据上训练。结果显示,基于频段功率的频谱特征在粗粒度分类中平均逐试次准确率为49.03% ± 4.18%,明显高于时域统计特征的37.97% ± 3.79%,而且少数几个频段就承载了大部分可区分信息。该研究为预印本,尚未经同行评审。 查看详情 →
09-16 韩国 论文发表 基础与方法 脑电转文字被曝高估:随机噪声也能骗过部分解码器 把脑电直接翻译成自由文本,一直被视为非侵入式脑机接口最有想象力的方向。但一项针对多个已发表解码器的测试发现,把真实脑电换成随机噪声后,部分模型仍能输出流畅句子,成绩与用真实脑电时相当,说明语言模型可能承担了大部分工作。该领域随后把噪声基线测试和无教师强制解码列为新的验证惯例,同时用脑磁图作对照,量化了脑电与更清晰信号之间的差距。 查看详情 →
09-16 论文发表 基础与方法 单通道脑电去噪新框架SPAR-EEG:P300拼写准确率提升7.8个百分点 可穿戴神经技术与脑机接口应用,包括辅助交互界面和临床监测,都希望用上单通道脑电,因为电极少、佩戴负担轻。但单通道脑电信号中的肌电、眼电和运动伪迹难以去除,尤其在缺少辅助通道、伪迹标签或人工挑选的干净基线片段时。SPAR-EEG框架无需这些额外条件,对每个脑电分段施加三段针对特定伪迹的衰减处理:基于变分模态分解的一段处理高频肌电爆发,基于奇异谱分析的两段分别处理眨眼样眼电瞬变和缓慢运动漂移。它在26个信噪比水平上均取得最优伪迹区信噪比改善,并在仅用FP1和FP2两个导联的P300拼写任务中把最终准确率提高7.8个百分点。 查看详情 →
09-16 论文发表 康复与辅助 成人探索研究发现脑机接口学习表现与阅读进步相关 研究者开发了一种结合听觉输入与视觉反馈的非侵入式脑机接口,通过头皮脑电采集信号,目标是改善发展性阅读障碍相关的语音加工,并首先在有、无阅读障碍的成人中测试。参与者完成16次训练,前后接受语音意识和阅读能力评估。在学会使用脑机接口的参与者中,包括阅读障碍组和控制组,离线脑机接口分数与非词阅读能力的提高显著相关;脑机接口学习表现还与真实单词阅读及声音振幅上升时间辨别能力的改善显著相关。这些关联不能证明训练导致阅读改善,也不能直接外推至婴儿或儿童。本研究为预印本,尚未经同行评审。 查看详情 →
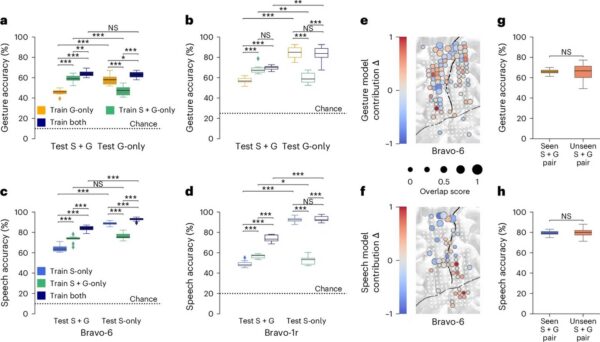
09-15 论文发表 沟通与语言 单个皮层脑电植入体同时解码语音和手势,3名瘫痪患者借此驱动虚拟化身 瘫痪患者往往同时失去说话和做手势的能力,而以往的脑机接口大多只解码其中一种。加州大学旧金山分校研究团队发现,仅用一个贴在大脑皮层表面的高密度电极植入体,就能同时读出患者想说的话和想做的手势。3名瘫痪参与者尝试说话、做手势,或两者同时进行,就能控制一个按本人定制的虚拟化身。研究人员还发现,模型同时用单独动作和同时动作的数据训练,在各种场景下表现都更好。这项研究表明,一个植入体可以同时控制多种动作输出,让脑机接口的交流方式更接近自然对话。 查看详情 →
09-10 论文发表 基础与方法 P300拼写器并非组件越多越好,四组件全因子试验揭示反协同效应 P300脑机接口拼写器常被设计成把多个各自有效的组件全部打开,默认组件越多性能越好。一项预印本研究用四组件全因子试验检验了这个假设:组件的价值是有条件的,而不是可叠加的。受试者校准是最强的单一贡献者;欧几里得对齐能在零校准设置下弥补校准的缺失;把各自有用的组件叠加起来反而可能拉低性能,作者称之为组件反协同。语言模型的支持也并非普遍有益,其效果强烈依赖底层脑电流水线的强度。 查看详情 →