中 / EN

语音解码

43 条

语音解码旨在将大脑的语言信号直接转化为文字或合成语音,为失去说话能力的患者恢复沟通。本专题追踪皮层电极和非侵入方式在词汇解码、连续语句生成方面的最新突破。

2026 年 10 月

Araya Inc.参与研究:脑电语音解码贡献不能仅用肌电关联解释

Araya Inc.与Sincxpress Education SRL研究人员分析了利用超高密度脑电预测口语单词的模型,考察解码依据是否来自神经活动,而非说话时的肌肉电活动。结果显示,各电极对解码的贡献无法用其与肌电的互信息解释;脑电解码依赖的时段也不同于仅使用肌电的解码。有声言语与极轻微外显言语的脑电解码贡献时段存在部分重叠。在所有言语条件下,去噪均增强了言语相关脑区电极对解码的贡献。作者据此认为,适当预处理有助于利用脑电中的神经活动解码口语单词。
脑信号转文字新方法用更少参数完成两项基准测试

研究团队提出名为BEST的两阶段方法,将神经活动转换为文字,探索语音脑机接口是否必须依赖大模型。在Brain-to-Text '24和'25两项基准测试中,该方法的词错误率分别为6.19%和1.62%,参数量仅为可比方法的3.85%。词错误率衡量输出文字相对参考文本的错误程度,数值越低表示错误越少。作者的分析认为,扩大解码器并不总能带来更好的表现,神经信号、语音与文字之间的对应关系比模型大小更关键。这些结果属于基准测试表现,不能直接等同于日常交流效果。

脑电语音解码审查发现:出声说话的对照表现主要由肌源信号主导

研究人员审查三个公开语料库,发现出声说话时的解码表现可能不足以证明流程能识别脑源语音信号。在ds003626中,两个唇部电极的解码准确率为0.7430,高于128通道头皮电极阵列的0.4231;限制在8-30Hz后,未保留可解码信号。研究还向真实记录注入已知幅度的效应,测量不同方法能检测到多小的变化,发现方法之间存在差异。作者认为,这些语料库的外显言语阳性对照主要由肌源性信号主导,并建议同时报告频段、伪迹通道表现及实测检测下限,以帮助解释解码成功或未检出的结果。

想象语音解码跨人测试接近随机水平,研究复核三个脑电语料库

研究人员分析三个公开语料库,检验用一人的头皮脑电训练的想象语音解码器能否用于另一人。在482个受试者有序对中,没有任何一对在多重比较校正后保持显著;各语料库的平均迁移准确率与随机水平相差均不超过0.006。研究还发现,区分想象任务与刺激前静息的信号,更符合刺激后状态,而非想象活动本身。单人内部解码中,只有竞赛语料库的所有受试者均超过阈值,但其频率特征未通过伪迹审查。结果限定于这些语料库和所检验的表示方式,不能推广为所有想象语音解码均不可行。

研究将脑电与文本对齐,探索想象语音的语义解码

研究人员将想象说话时的脑电信号与文本的语言表示对齐,希望在识别固定意图之外,利用不同表达之间的语义关系。研究在Chisco想象语音数据集的5名受试者、39个意图类别上评估了这一框架,解码表现与针对该任务优化的闭集分类器相当。脑电与文本的最大相似度还能筛选出Top-1和Top-5准确率更高的留出试验子集。五个语义维度的平均一致率均高于50%的机会水平参照;对未见候选句子的比较则属于定性展示,不能据此认定系统已能自由读取任意想象语句。

语言描述辅助脑信号解码,语音任务准确率最多提高17.15个百分点

研究者用自然语言描述待识别的类别,帮助模型学习脑信号与类别之间的对应关系,并在视觉、运动和语音解码任务中评估这一方法。研究覆盖七种编码器架构,使用头皮和颅内记录,各任务模型独立训练。与匹配的类别标签监督基线相比,语音解码准确率最多提高17.15个百分点。研究还报告,所学表征支持候选类别集合复用,以及有标签监督的受试者和会话适配;在稳态视觉诱发电位任务中,可在特定条件下解码训练中未见过的频率。这些结果并不代表一个统一模型已能直接完成全部任务,或无需标签即可适配新受试者。本研究为预印本,尚未经同行评审。

上下文先验让脑磁图解码更准,也让部分错误更自信

给脑磁图语音解码加上下文先验,能提高整体准确率,但一项新研究提示,这也会让一部分本可纠正的错误变得更“自信”。研究团队在两个脑磁图数据集上追踪候选词得分变化,发现一种反转:正确候选原本排在局部前列时,融合后前两名的分差越大越可能被纠正;起始排名靠后时,分差越大反而更可能维持错误。在MEG-MASC上,整体判断正误的AUROC为0.87,而区分“纠正”与“残留错误”的AUROC从0.70跌到0.39;起始排名第20位之后的错误占融合后错误的46.6%。作者建议,置信度不应只读融合后的分数,还要保留局部与上下文证据;拆分后解码器可在74.5%的时间窗内作答,高于原来的56.7%。该研究为预印本,尚未经同行评审。
2026 年 9 月

一块脑表电极同时读出说话和手势,瘫痪患者让虚拟化身边说边比划

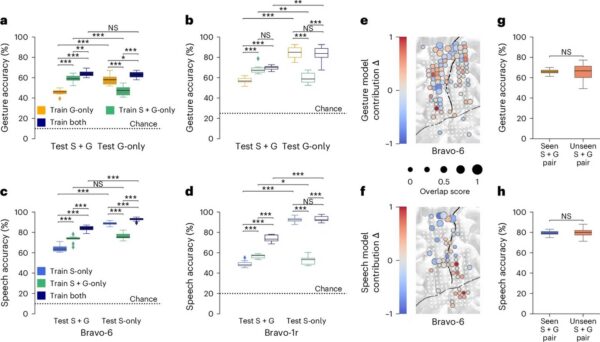
瘫痪患者能否同时说话和做手势?据ApplySci报道,一个研究团队用一块高密度皮层脑电植入体做到了同时解码。皮层脑电是贴在大脑表面记录电信号的电极阵列。参与者只需尝试说话或做手势,个性化虚拟化身就会跟着说话或做动作,两种表达可以同时进行,也可以分开进行。研究人员原以为同时表达时的脑信号只是两种模式的简单叠加,实际数据却与单独说话或单独做手势时明显不同。参与者练习的词汇量有限,最多10个手势和10个单词或短语。报道指出,目前的标准做法是眼动追踪,这种方式速度慢、表达受限且令人身体疲惫,因此即便词汇量较小,这一方向也显示出改进的可能。

语音脑机接口综述:评价标准不应只看离线准确率

语音脑机接口想做的,是把与说话、语言或交流意图相关的神经活动转成文字、合成语音或虚拟形象的动作,帮失去说话能力的人重新交流。这篇综述认为,它并不只是一台把脑信号翻译成文字的解码器,而是一个会随时间变化的临床系统:神经表征、记录硬件、解码算法、语言模型、反馈和使用者自身的学习相互影响。作者提出,下一代语音脑机接口不能只比离线准确率,还要看跨天使用是否稳定、校准负担多重、延迟多长、能否表达不确定性、好不好用,以及能否防止把不想说的话解码出来。该研究为预印本,尚未经同行评审。

语音脑机接口不配GPU也行:云端小模型挑句子,错词率不输70亿参数大模型

语音神经假体从大脑活动中解码患者尝试说出的话,最后一步通常要用一个数十亿参数的语言模型给候选句子重新打分,这是整套系统里唯一需要GPU的环节。Gabriele Cinà于2026年9月27日在arXiv发布的研究改用托管模型Jev,一次调用给每个候选句子输出一个概率,再与解码器自身的评分结合。在一名渐冻症(ALS)参与者的978个保留句子上,已发表解码器单独使用时词错误率为8.1%,Jev为7.5%,OPT-6.7b与Qwen2.5-7B均为7.8%;重新调整解码器权重后,三者分别为6.9%、7.2%和7.4%。Jev不需要GPU,每千句成本0.07美元,经互联网的端到端延迟为262毫秒,慢于本地GPU上7B模型的27毫秒。该研究为预印本,尚未经同行评审。

从脑信号读“心里默念的话”:信号越弱,语言模型帮的忙越大

想象中说的话,比耳朵听到的话更难从脑信号里读出来:大脑反应弱、噪声大,可用的数据也少。研究团队用一套同一批内容既“听”又“想”的脑磁图(MEG,一种在头皮外记录大脑磁场的无创技术)数据集,在训练和解码两个环节接入语言模型。结果显示,想象语音从语言模型中获益比听到的语音更多,而且最佳效果需要更多依赖语言模型。作者据此认为,脑信号证据越弱,语言模型提供的上下文先验越有用。该研究为预印本,尚未经同行评审。

融合功能磁共振与脑磁图的新方法提升跨被试语音解码准确率

研究人员提出名为SICMD的方法,把功能磁共振成像(fMRI)和脑磁图(MEG)两种非侵入式脑信号结合起来,从大脑活动中识别一个人正在听的语音,并且让同一个模型适用于不同的人。fMRI擅长定位活动发生在哪里,MEG擅长捕捉活动发生的时间,两者结合可以得到更完整的时空信息。在跨被试的感知语音解码任务中,该方法的Top-1、Top-10和Rankacc三项指标比基线方法分别提高10.6%、10.1%和1.7%以上。与多被试解码和被试内解码相比,训练成本分别降低88.8%和60.5%。该研究为预印本,尚未经同行评审。

想象语音脑电解码接受跨被试检验,频谱特征准确率达49.03%

只在心里默念、不发出声音的“想象语音”,能否从头皮脑电中读出来,并且换一个没参与训练的人也同样有效?研究人员用严格的被试无关方案重新检验了一个多类想象语音脑电数据集:模型从不在测试对象本人的数据上训练。结果显示,基于频段功率的频谱特征在粗粒度分类中平均逐试次准确率为49.03% ± 4.18%,明显高于时域统计特征的37.97% ± 3.79%,而且少数几个频段就承载了大部分可区分信息。该研究为预印本,尚未经同行评审。

非侵入式脑信号解码四种语言词汇,分层框架在九项条件中全面超越基线

从头皮脑电和脑磁图这类非侵入式记录中解码单个词汇,一直是脑机接口领域的难题,因为信号弱、时间分散,且混杂着声学、词汇和语义结构。深度学习已能从颅内记录中解码语言,但将这一能力推广到非侵入式记录仍是未解课题。由Yueyang Li、Shuran Chen、Wai Ting Siok和Nizhuan Wang提出的HDND(分层动态神经解码)框架将词汇解码视为逐步精炼而非一步到位的标签检索,在涵盖英语、荷兰语、普通话和粤语的七个脑电与脑磁图数据集、九种实验条件下,参与者平均平衡Top-10点估计值均高于匹配的上下文词汇解码基线,其中八项条件下取得所有对比方法中的最高均值。该研究为预印本,尚未经同行评审。

脑电转文字被曝高估:随机噪声也能骗过部分解码器

把脑电直接翻译成自由文本,一直被视为非侵入式脑机接口最有想象力的方向。但一项针对多个已发表解码器的测试发现,把真实脑电换成随机噪声后,部分模型仍能输出流畅句子,成绩与用真实脑电时相当,说明语言模型可能承担了大部分工作。该领域随后把噪声基线测试和无教师强制解码列为新的验证惯例,同时用脑磁图作对照,量化了脑电与更清晰信号之间的差距。

单个皮层脑电植入体同时解码语音和手势,3名瘫痪患者借此驱动虚拟化身

瘫痪患者往往同时失去说话和做手势的能力,而以往的脑机接口大多只解码其中一种。加州大学旧金山分校研究团队发现,仅用一个贴在大脑皮层表面的高密度电极植入体,就能同时读出患者想说的话和想做的手势。3名瘫痪参与者尝试说话、做手势,或两者同时进行,就能控制一个按本人定制的虚拟化身。研究人员还发现,模型同时用单独动作和同时动作的数据训练,在各种场景下表现都更好。这项研究表明,一个植入体可以同时控制多种动作输出,让脑机接口的交流方式更接近自然对话。

Paradromics脑机接口首例参与者实时说出自选语句

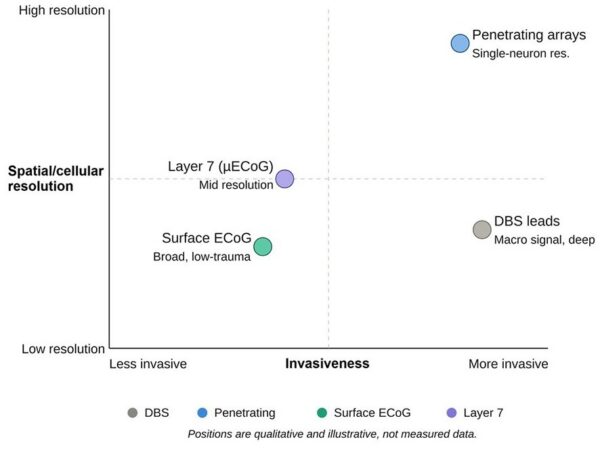
密歇根一名因运动神经元病几乎失去说话能力的女性,通过植入大脑表面的Connexus设备,用脑信号实时生成自己想说的话,并与家人通话。设备边缘的421根铂铱微丝记录单个神经元信号,软件把信号解码成文字和合成语音。这是FDA批准的Connect-One早期可行性研究的一部分,设备仍属研究性器械,公司计划随访6年观察安全性与耐久性。

大语言模型补全意图,P300拼写击键次数减少超过62%

这篇综述梳理了P300脑机接口从经典拼写器到AI代理的演进路径。P300是大脑看到罕见刺激后约300毫秒出现的正向电位,系统靠它判断用户想选哪个字符。综述指出,ChatBCI、MindChat等近期系统把P300拼写器与大语言模型结合,击键次数减少超过62%,通信速度提高到近三倍。作者还提出一套端到端架构:脑电头戴设备加实时CNN检测器,再加一层由大语言模型规划器和物联网控制接口组成的AI代理层。

阶梯医疗无线植入式汉语语音神经假体试验计划招募4人

上海阶梯医疗科技有限公司的无线植入式脑机接口系统进入人体评估阶段,面向言语障碍患者,试验编号NCT07647315,2026年9月1日实际开始,目前正在招募,计划入组4人。试验为前瞻性单臂设计,受试者接受手术植入并接受脑控训练,随访期预计12个月,期间记录不良事件、严重不良事件和器械缺陷,并收集脑控交互与沟通的有效性数据。主要终点预计2028年8月30日完成,整体预计2028年12月30日结束。登记记录没有公布植入部位、解码方式和纳入排除标准的细节,也没有阶段性结果,安全性与有效性结论要等随访数据。

P300拼写器并非组件越多越好,四组件全因子试验揭示反协同效应

P300脑机接口拼写器常被设计成把多个各自有效的组件全部打开,默认组件越多性能越好。一项预印本研究用四组件全因子试验检验了这个假设:组件的价值是有条件的,而不是可叠加的。受试者校准是最强的单一贡献者;欧几里得对齐能在零校准设置下弥补校准的缺失;把各自有用的组件叠加起来反而可能拉低性能,作者称之为组件反协同。语言模型的支持也并非普遍有益,其效果强烈依赖底层脑电流水线的强度。

不用开颅也能读语音:OPM-MEG解码准确率高出脑电3.6个百分点

10名母语为汉语的受试者朗读6个单元音韵母,同一套任务下同时记录光泵磁强计脑磁图与脑电。在刺激后150至500毫秒窗口内,OPM-MEG在全部5种分类器上的解码准确率都显著高于脑电。表现最好的组合是共空间模式(CSP)特征加线性支持向量机,OPM-MEG平均准确率60.3%,脑电56.7%。这意味着无需植入电极、也不限制头部活动的语音脑机接口,可能有一条比脑电更清晰的信号通路。

研究团队提出单阶段脑信号转语音框架,无需先解码成文字

失去说话能力的瘫痪患者,能不能让机器直接把脑信号变成声音?多数现有语音脑机接口要先把脑信号解码成文字,再用语音合成读出来,两步串联既拖慢速度,前一步的错误还会传到后一步。研究团队提出的Brain2Speech-Net跳过文字这一环,把较长的神经记录直接映射到语音合成模型内部的表示空间。据作者报告,在其对比的系统中,它是唯一既能生成可懂语音、生成速度又快于实时的系统。该研究为预印本,尚未经同行评审。

微调降到10分钟,PNPL竞赛让脑机语音适配进入临床可行范围

一项于2026年9月3日上传至arXiv的预印本公布了2026年PNPL竞赛的任务设定。该竞赛基于扩展的LibriBrain100数据集,包含32名新增被试,每人约40分钟数据,并新增约80小时的个体内数据。竞赛设2个赛道,Deep赛道关注个体内词分类,追求最佳性能;Broad赛道关注跨被试泛化,将个体微调数据从约40分钟逐步减少至20分钟、10分钟,接近临床可行范围。2025年竞赛的获胜者在语音检测和音素分类任务上分别达到95.6%和73.6%的F1分数。该预印本未经同行评审。

语音脑机接口缺少统一度量,新指标OVMI让不同系统可比

语音脑机接口(speech BCI)将神经活动转化为语言,有望帮助瘫痪患者恢复沟通。然而,由于不同系统使用不同的数据集、记录方法、语音类型和词汇表,其报告的准确率等指标难以直接比较。研究人员提出开放词汇互信息(OVMI),一种信息论度量,用于在统一尺度上评估不同系统的通信能力。研究表明,仅基于系统支持词汇计算的准确率等常规指标可能高估系统传达用户意图语音的能力。通过选择最大化OVMI的词汇,在3个语音领域中实现了最高16.3%的相对准确率提升。该研究以预印本形式发布于arXiv,尚未经过同行评审。

逐层对比学习挑出神经可见层,脑电图像检索准确率升至86.4%

一项预印本研究提出,通过逐层对比学习选择CLIP模型的中间层作为神经可见性最优层(NVOL),可改善脑电(EEG)信号与图像语义特征之间的跨模态对齐。在THINGS-EEG数据集上,基于NVOL的200-way图像检索平均Top-1准确率达78.1%,结合CSLS后升至86.4%。该框架还把检索与生成耦合,利用条件扩散先验重建受试者特异的NVOL特征,再映射至CLIP空间驱动Stable Diffusion XL生成图像,在语义与结构指标上优于单阶段末层扩散。该研究2026年9月2日上传至arXiv,尚未经同行评审。
2026 年 8 月

超100小时脑磁图数据开放:LibriBrain100加速非侵入式语音解码研究

一个名为LibriBrain100的大型脑磁图(MEG)数据集于2026年8月25日发布,包含超过100小时的高质量数据,其中约80小时来自单一受试者,创下同类数据集中个体内数据深度的新纪录。该数据集旨在为神经语音解码研究提供标准化评估基准,并附带开源工具和在线竞赛。研究团队利用现有解码模型在词分类基准上取得了最先进性能,验证了数据质量和大规模个体内数据的价值。此外,数据集还包含32名受试者每人约40分钟的额外数据,以补偿个体数据不足。

38名儿童设计自己的脑控沟通界面:他们想要动画、颜色和声音

一项针对38名8至12岁典型发育儿童的研究让他们使用P300脑机接口增强与替代沟通(P300-BCI-AAC)设计应用,创建自己偏好的图片界面,以了解儿童对这类沟通界面的设计偏好。研究发现,儿童普遍选择喜欢的颜色、动画效果(尤其是缩放动画)和声音提示;动画有助于视觉可达性和目标定位,背景颜色变化用于融入偏好色彩,视频GIF和图片覆盖层则增加个人相关性。这些发现强调了运动、颜色、个性化和视觉清晰度在儿童BCI-AAC界面中的初步重要性,为开发可定制、有吸引力的系统奠定了基础,也为未来纳入日常使用AAC的儿童及运动障碍人群的研究提供了方向。

可解释脑机接口框架:结合情感识别提升意念转语音解码

一项新研究提出一种可解释的脑机接口(BCI)框架,将情感状态识别与脑电(EEG)信号解码相结合,用于实现情感感知的意念转语音(thought-to-speech)。该框架在公开的想象语音EEG数据集上进行了测试,采用受试者独立设置,评估了分类准确率、精确率、召回率、F1分数、推理速度和可解释性。结果显示,与传统不透明模型相比,该方法持续提升了解码可靠性,并提供了清晰、具有临床意义的见解。研究为瘫痪、肌萎缩侧索硬化症、闭锁综合征等影响自然言语的患者提供了辅助沟通工具的实际基础。

深部脑刺激到脑机接口,综述梳理植入式神经技术的三个共同瓶颈

迷你综述指出,深部脑刺激系统、脑机接口和言语神经假体等脑植入物正从概念验证走向早期临床部署,尽管针对的临床问题不同,却共享传感、解码、刺激或输出、供电与遥测、慢性临床验证构成的闭环架构,转化速度由这些共享环节的瓶颈决定。近期里程碑包括一个皮层接口获监管批准、植入式BCI试验不断增多。综述对比了从开环走向闭环的深部脑刺激、恢复运动与感觉功能的脑机接口、以及把尝试言语解码为文本、语音和面部动画的言语神经假体三条线,并梳理柔性电极、AI辅助解码与神经形态边缘处理等进展,认为三类技术始终卡在长期稳定性、神经编码与公平可及三个共同瓶颈上,需要配套治理框架。该研究2026年8月19日发表于《Frontiers in Neuroscience》。
© 2026 BCIwiki.com 产业简报 主题索引 提交线索 订阅本站 修订记录 关于我们